Der erste Eintrag ist immer die Quelle des Pins. Die Gesamtsicherheit ist ein gewichteter Durchschnitt, wie fest jeder Beleg die oben verwendeten Start- und Endzeiten stützt; ein Beleg zählt für je 180 Tage, die er älter ist als der neueste, nur halb so viel.
Datierte Google[3]-Ankündigung; Kommerzialisierungsmeilensteine werden in der Quellenzeitleiste separat erfasst.
Fehlt etwas oder stimmt etwas nicht? Sag es in deinen eigenen Worten: ein Link, der diesen Pin belegt, ein anderes Start- oder Enddatum und warum, oder eine Angabe, die fehlt oder falsch ist. Die KI prüft es an den Quellen dieses Pins, sucht nach besseren und ergänzt jede Seite, die dich bestätigt. Die eigenen Quellen des Pins zählen weiterhin am meisten. Auch Bilder sieht sich die KI an: Eines, das etwas anderes oder die Sache schlecht zeigt, wird nach hinten gestellt oder ersetzt.
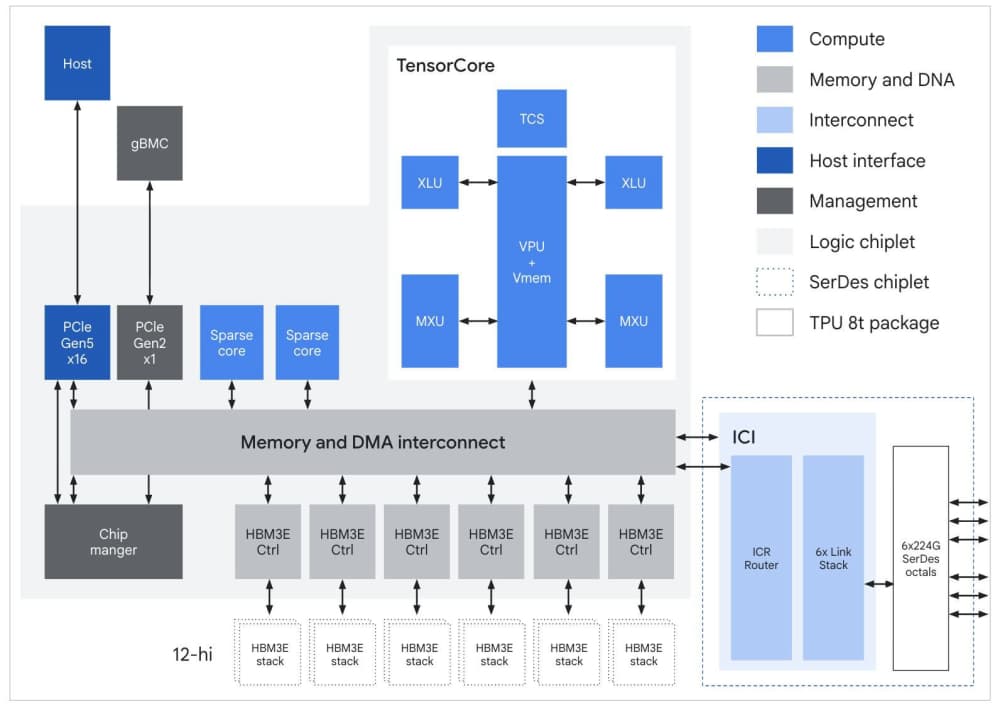
| Maker-Architekturtisch[1][3] |
| On-Chip-SRAM | 128 MB | Vmem in der Maker-Tabelle[1][3] |
|---|
| Superpod-Größe | 9.600 Chips | 3D-Torus[1][3] |
|---|
| Host-CPU | Arm Axion | Maker-Architekturtisch[1][3] |
|---|
| Produkt | Veröffentlichter Kontext |
|---|---|
| Trainium2 / EC2 Trn2 | EC2 Trn2-Trainingsinstanzen skalieren auf 16 Trainium2-Chips und insgesamt 1,5 TB HBM3 pro Instanz. |
| B200 | Blackwell-GPU mit bis zu 180 GB HBM3/3e gemäß NVIDIA-Tuning-Guide.[5][6] |
| H200 | Hopper-GPU mit 141 GB HBM3e und 4,8 TB/s Bandbreite.[5][6] |
Produktkontext, kein Benchmark-Ranking. GPU-, TPU- und Cloud-Instanz-Spitzenraten sowie Speichereinheiten können unterschiedlich sein.
Originaltitel: Google Announces TPU 8t for Frontier AI Training
EC2 Trn2 training instances scale to 16 Trainium2 chips and 1.5 TB total HBM3 per instance.
Quelle