La première entrée est toujours la source de l’épingle. La confiance globale est une moyenne pondérée de la fermeté avec laquelle chaque référence étaye les heures de début et de fin retenues ci-dessus ; une référence compte moitié moins pour chaque tranche de 180 jours d’ancienneté par rapport à la plus récente.
Annonce datée de Google[2][3] ; les étapes de commercialisation sont enregistrées séparément dans le calendrier source.
Il manque quelque chose ou une erreur s'est glissée ? Dites-le avec vos mots : un lien qui étaye cette épingle, une autre date de début ou de fin et pourquoi, ou une information absente ou erronée. L'IA la vérifie au regard des sources de l'épingle, en cherche de meilleures et ajoute toute page qui vous donne raison. Les sources de l'épingle restent celles qui comptent le plus. L'IA regarde aussi les images : une image qui montre autre chose, ou qui le montre mal, passe en dernier ou est remplacée.
| HBM physique | 96 Gio par puce | 95 Gio utilisables dans le tableau de documentation[1][2][3] |
|---|
| Bande passante HBM | 2 765 Go/s par puce | Spécification du fabricant[1][2][3] |
|---|
| Taille des gousses | 8 960 jetons | Tore 3D[1][2][3] |
|---|
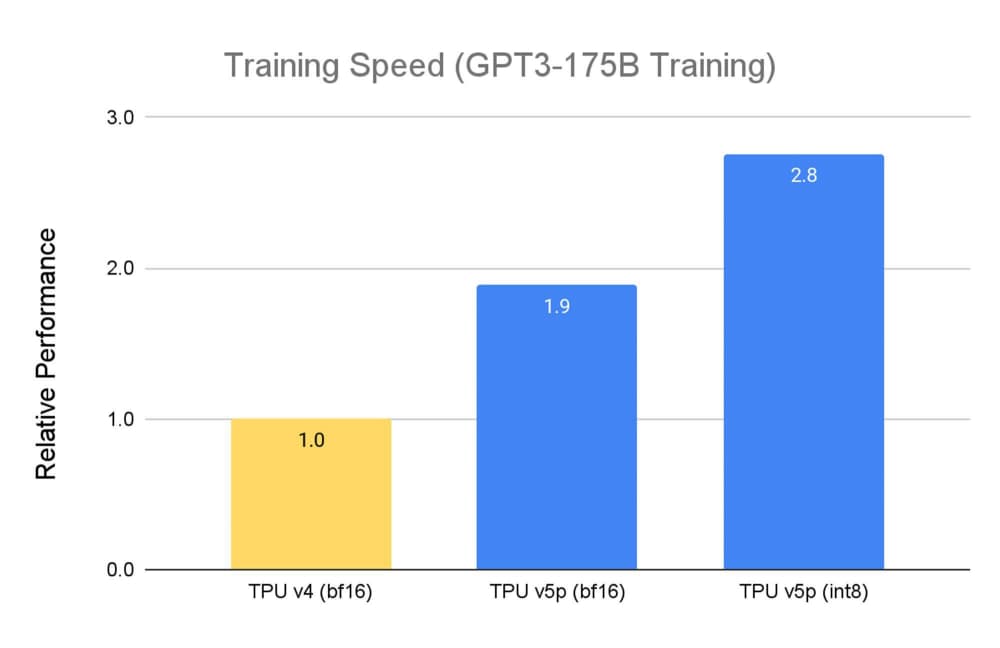
| Vitesse d'entraînement GPT-3 175B | 2,8x TPU v4 | Exécution interne de Maker, novembre 2023 ; par puce normalisé[1][2][3] |
|---|
| Produit | Contexte publié |
|---|---|
| H100 SXM | GPU Hopper avec 80 Go HBM et 3,35 To/s de bande passante ; les choix de cadre et de précision affectent les comparaisons.[4][5] |
| A100 | Expédition de l’accélérateur de formation et d’inférence Ampere à partir de mai 2020 ; prend en charge le partitionnement GPU multi-instance.[4][5] |
Contexte du produit, pas un classement de référence. Les taux de pointe et les unités de mémoire des GPU, TPU et instances cloud peuvent différer.
Titre original: Google Announces TPU v5p and the AI Hypercomputer